[!IMPORTANT] Utilisez uniquement des invites synthétiques. La journalisation des messages LLM reste désactivée sur chaque API : le laboratoire n’enregistre jamais les invites ni les réponses dans la télémétrie; seuls les nombres de jetons et des dimensions bornées quittent la passerelle. Les images de session apparaissent sur ce site seulement après qu’une personne responsable a examiné les preuves expurgées.
Aperçu
| Élément | Valeur |
|---|---|
| Durée | 45 minutes, plus le temps d’approbation et d’approvisionnement |
| Niveau | Intermédiaire |
| Prérequis | Amorçage administratif terminé, droits de révision sur l’environnement GitHub lab et un ensemble de paramètres de modèle approuvé |
L’environnement est un groupe de ressources déployé à partir de infra/main.bicep : une instance APIM Basic v2 avec une identité managée attribuée par l’utilisateur, un déploiement de modèle approuvé, une ressource Azure AI Content Safety, un espace de travail Log Analytics et Application Insights adossé à cet espace de travail. L’API de plateforme ai-gateway-api utilise le back-end ai-gateway-foundry et expose trois produits d’équipe : team-retail, team-finance et team-hr.
[!WARNING] Basic v2 est un choix conditionnel. Sa passerelle est un point de terminaison public, sans point de terminaison privé entrant ni connectivité privée vers les back-ends; le déploiement exige donc l’approbation explicite de cette exposition publique. Lorsque le réseau privé est requis, choisissez Standard v2 et validez cette topologie séparément. La prise en charge documentée des stratégies ne prouve pas que le laboratoire fonctionne tant que les preuves de la session ne sont pas concluantes.
Une personne administratrice exécute scripts/bootstrap-lab.ps1 une seule fois, hors de tout flux de travail. Le script crée le groupe de ressources du laboratoire, un groupe de ressources d’identité distinct qui contient l’identité attribuée par l’utilisateur d’APIM, les rôles personnalisés, les deux identités fédérées de déploiement et d’exécution, ainsi que l’environnement protégé lab. Les flux de travail n’exécutent jamais l’amorçage et n’écrivent jamais d’attributions de rôles.
Objectifs d’apprentissage
À la fin de cet atelier, vous serez capable de :
- Expliquer ce que crée l’amorçage administratif et pourquoi les flux de travail ne l’exécutent jamais
- Choisir le mode de
lab-session.ymlqui correspond à l’autorité que vous comptez accorder - Lire les résultats de la vérification préalable et de l’analyse what-if d’une exécution à blanc avant d’approuver un déploiement payant
- Expliquer comment l’enregistrement de manifeste limite le nettoyage ultérieur aux ressources créées par cette session
- Interpréter le sommaire de préparation et l’enveloppe budgétaire de la session
Exercices
Exercice 0.1 : Lire les paramètres approuvés
Get-Content infra/main.bicepparam
Résultat attendu : chatModelName, chatModelVersion, chatDeploymentSku, chatDeploymentCapacity, aiLocation et generation n’ont aucune valeur par défaut, et allowGlobalProcessing vaut false.
Aucun modèle, aucune version, aucune SKU, aucune région ni aucune capacité n’est choisi à votre place. L’emplacement canadien des ressources n’approuve pas le traitement d’inférence mondial; la vérification préalable rejette donc les types de déploiement Global, sauf si allowGlobalProcessing est défini explicitement.
Exercice 0.2 : Compiler les modèles sans informations d’identification
az bicep build --file infra/main.bicep
az bicep build-params --file infra/main.bicepparam
Résultat attendu : az bicep build réussit sans informations d’identification et sans avertissement autre que les suppressions documentées. az bicep build-params ne réussit qu’une fois définies dans votre interpréteur de commandes toutes les variables AIGOV_* énumérées dans infra/README.md; d’ici là, la commande échoue en nommant la variable manquante, de sorte qu’aucun modèle, aucune région ni aucune identité n’est jamais déduit du contrôle de code source.
La compilation prouve que les modèles sont bien formés. Elle ne prouve ni le quota, ni la capacité, ni l’admissibilité du modèle, ni le bon comportement des stratégies.
Exercice 0.3 : Choisir un mode de session
Chaque mode accorde une autorité différente. Le nettoyage agit toujours uniquement sur les ressources consignées dans le manifeste propre à la session en cours.
| Mode | Déploie | Exécute les carnets et le trafic | Nettoyage |
|---|---|---|---|
dry-run |
Non | Non | Aucun; s’arrête après la vérification préalable et what-if |
full-session |
Oui | Oui | En cas de réussite et d’échec, sauf si keep_environment=true |
deploy-only |
Oui | Non | Seulement si le déploiement ou la préparation échoue |
run-existing |
Non; vérifie le manifeste | Oui | Aucun; l’environnement est conservé |
report-only |
Non; vérifie le manifeste | Rapport de répartition des coûts seulement | Aucun; l’environnement est conservé |
lock-test |
Non | Non | Aucun; répète le verrou du flux de travail sans Azure |
Résultat attendu : vous pouvez nommer les modes qui conservent les ressources en cas d’échec (run-existing et report-only) et le seul indicateur qui conserve un environnement full-session (keep_environment=true, qui signale aussi l’exposition continue aux coûts).
Exercice 0.4 (pratique) : Lancer une exécution à blanc
gh workflow run lab-session.yml -f mode=dry-run -f generation=<generation> -f confirm_resource_group=<groupe-de-ressources>
Résultat attendu : après qu’une personne réviseure a approuvé l’environnement lab, la session se connecte avec l’identité de déploiement, exécute la vérification préalable et what-if, puis s’arrête. Aucun enregistrement de manifeste, aucun déploiement ni aucun nettoyage n’a lieu.
La vérification préalable contrôle l’ensemble de paramètres du modèle, l’inscription des fournisseurs, la disponibilité régionale d’API Management, le quota du modèle, la disponibilité de Content Safety ainsi que les noms APIM, Cognitive Services et Log Analytics supprimés de manière réversible qui entreraient en collision. L’analyse what-if échoue en cas de suppression inattendue ou de modification hors des identifiants de ressources prévus.
Exercice 0.5 (pratique) : Déployer et lire la préparation
Lancez une exécution full-session ou deploy-only avec les mêmes entrées, puis approuvez-la. Ces modes, comme run-existing, refusent de démarrer tant que la variable de dépôt AIGOV_PRICE_SNAPSHOT ne désigne pas un fichier d’instantané de prix approuvé sous scripts/prices/.
Résultat attendu : la session écrit un enregistrement de manifeste en ajout seulement, nommé aigov-manifest-<generation>-<session_id>-<hash8>, avant toute modification, déploie en mode incrémentiel et écrit outputs/readiness/<session_id>/summary.json avec un état par vérification.
La préparation interroge la passerelle, la relecture de l’enregistreur et du diagnostic, y compris les dimensions des métriques personnalisées, l’état d’approvisionnement du compte Content Safety, un appel de modèle par l’API de plateforme à /ai-gateway ainsi que la première ingestion de métriques. Le premier appel Content Safety par la passerelle a lieu dans l’atelier 04. Un échec de préparation ou de sondage des portées fait sauter chaque carnet, le trafic et la répartition des coûts; les preuves et le nettoyage prévu par le mode s’exécutent quand même. L’enveloppe de session plafonne les tentatives, les jetons réservés, la dépense estimée et la durée, et chaque appel de modèle ou de sécurité effectue sa réservation avant l’envoi.
Exercice 0.6 : Examiner les preuves de la session
[!NOTE] Preuves examinées de la session
36608221120-1(exécution du flux de travail), produites le 2026-09-29 uniquement à partir de résultats expurgés.
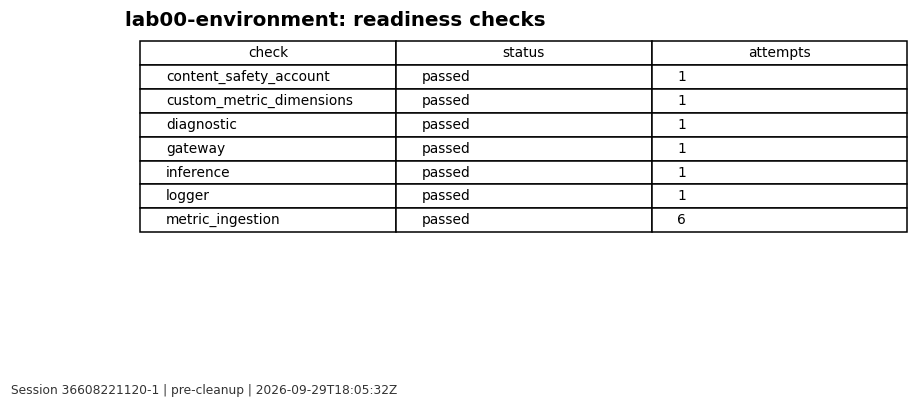
Liste de vérification
- L’ensemble de paramètres du modèle et la génération sont explicites et approuvés
- Vous avez approuvé l’exposition publique de Basic v2 ou choisi Standard v2 pour le réseau privé
- Une exécution à blanc s’est terminée et son analyse what-if correspondait aux ressources prévues
- L’enregistrement de manifeste existe avant toute ressource déployée
- Chaque vérification de préparation indique un état dans le sommaire
Vérification des connaissances
- Pourquoi l’amorçage s’exécute-t-il une seule fois par une personne administratrice plutôt que dans un flux de travail?
- Quels modes peuvent supprimer des ressources, et selon quels résultats?
- Qu’est-ce qu’un échec de préparation fait sauter, et qu’est-ce qui s’exécute quand même?
- Pourquoi une commande
az bicep buildréussie ne prouve-t-elle pas que le laboratoire fonctionne?
Étapes suivantes
Passez à l’Atelier 01 : Configuration et validation.