Aperçu
| Élément | Valeur |
|---|---|
| Durée | 45 minutes |
| Niveau | Intermédiaire |
| Prérequis | Lab 03 |
Objectifs d’apprentissage
À la fin de ce lab, vous serez capable de :
- Exécuter trois scénarios synthétiques dans le chat authentifié et avec le script CLI lié à une version
- Lire une trace multi-agent et identifier quel nœud spécialiste a produit quelle partie de la réponse
- Vérifier le rappel et l’isolation avec historique complet, sans stockage natif des conversations
- Reconnaître une réponse saine par rapport à une réponse dégradée (outil indisponible)
Exercices
Foundry reste invocable depuis un client public approuvé : les sorties de l’agent dans le VNet ne désactivent pas son point public authentifié. Une réponse ou une session de chat réussie ne prouve ni l’accès Cosmos privé ni la persistance des checkpoints. Testez-les séparément selon Réseau Cosmos privé.
Exercice 4.1 : Invoquer depuis la CLI
À la racine du dépôt, dans la session PowerShell du Lab 02, utilisez votre propre environnement. Le script exige la configuration Git Bash du Lab 00 et les rôles d’exécution du Lab 03. Vérifiez le projet sélectionné avant l’appel :
azd env select $WorkshopEnv
if ((azd env get-value AZURE_RESOURCE_GROUP) -ne $ResourceGroup) { throw 'Wrong resource group' }
azd env get-value FOUNDRY_PROJECT_ENDPOINT
$env:AGENT_NAME = 'threat-assessment-agent'
$env:AGENT_VERSION = bash scripts/record-production-version.sh $env:AGENT_NAME .azure/workshop-agent
$env:AGENT_TEST_PROMPT = 'Assess synthetic device ID CREW-PORTAL-01 and account/user ID crew-admin. Investigate repeated MFA failures followed by a successful login from 203.0.113.45.'
bash scripts/invoke-agent.sh > .azure/workshop-smoke.sse
jq -Rse -f scripts/validate-agent-response.jq .azure/workshop-smoke.sse
Le script crée une session liée à la version et transmet input, stream:true
et store:false. Ne fournissez ni conversation ni previous_response_id
natifs. Le validateur exige un texte assistant complet ; HTTP 200 seul ne
prouve pas la réussite d’un flux SSE.
Exercice 4.2 : Examiner trois scénarios
L’atelier de base ne déploie pas d’application web. Exécutez ces trois cas sur votre agent avec le script d’évaluation du Lab 05. N’utilisez pas le pilote staging partagé d’un formateur ou d’un client pour terminer cet exercice.
Si votre administrateur déploie séparément un chat authentifié connecté à votre projet, vous pouvez aussi suivre le parcours facultatif ci-dessous. L’API anonyme doit retourner 401. HTTPS public ne signifie ni API anonyme ni réseau privé.
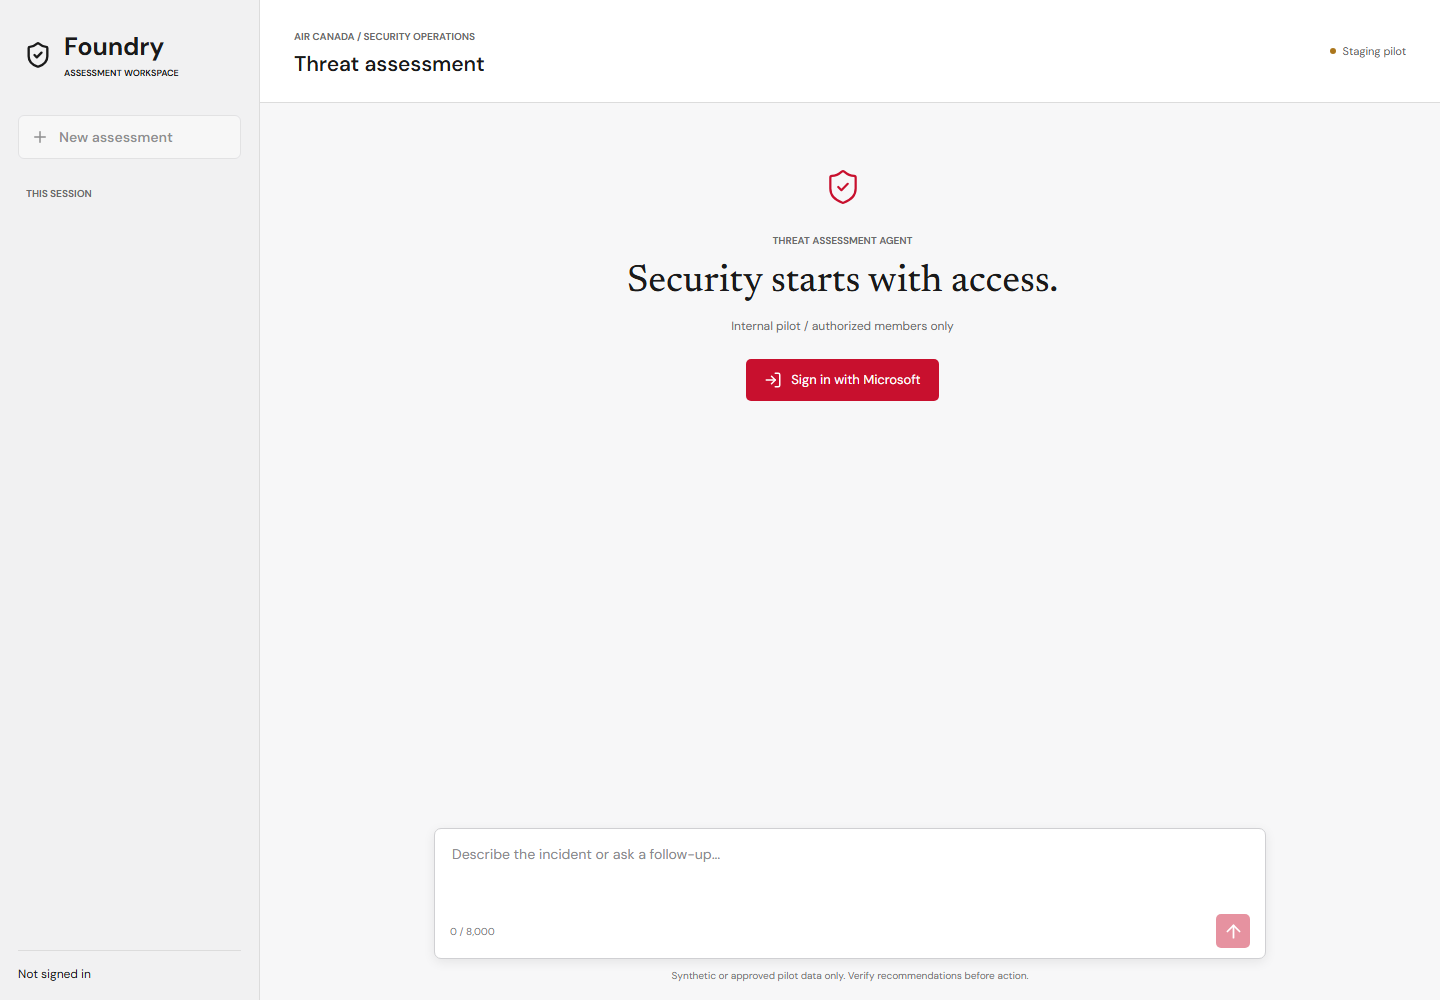
Aperçu visuel local capturé le 2026-09-15 avec une configuration fictive, avant connexion. Il ne prouve ni l’authentification, ni le déploiement, ni une réponse réelle de l’agent. Voir la capture mobile.
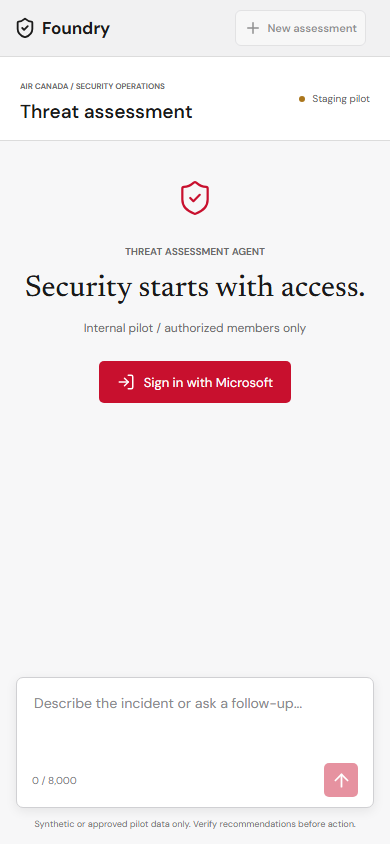
Choisissez New assessment pour chaque scénario indépendant. Sous Synthetic demo queries, sélectionnez un exemple, examinez ou modifiez le brouillon, puis choisissez Send message. La sélection seule n’appelle pas le modèle. Elle ne remplace pas un brouillon non vide et reste désactivée pendant une requête. Les prompts anglais restent identiques aux cas évalués.
| Exemple | Appels MCP attendus | Preuves à vérifier |
|---|---|---|
| Suspicious crew-admin login | get_device_risk, list_vulnerabilities, detect_login_anomalies |
CREW-PORTAL-01, crew-admin, échecs MFA puis succès ; escalade avec limites explicites |
| Approved employee travel | Les trois mêmes appels | JDOE-LT-01, jdoe, voyage approuvé et appareil connu ; ne pas inventer de compromission |
| Conflicting egress signals | get_device_risk, list_vulnerabilities, score_anomaly |
OPS-DB-02, 900 Mo/heure ; un endpoint sain n’annule pas une anomalie réseau |
Les prompts exacts de
samples.js
correspondent à tp-001, fp-001 et conflict-001 du jeu de référence.
Les champs appareil/compte/métrique explicites guident les appels déterministes.
Le 99e percentile n’est pas la mesure de trafic de 900 Mo/heure.
[!IMPORTANT] Le transport et les appels MCP sont réels, les données de sécurité sont synthétiques. Ces appareils de scénario n’ont pas de télémétrie de vulnérabilités ; un appel signalant cette absence ne prouve pas zéro vulnérabilité. Une mention d’outil dans le texte du modèle n’est pas un reçu.
Le Playground reste une surface d’inspection facultative, pas le client de référence pour l’historique. Une requête du portail ajoutant des identifiants natifs ne respecte pas ce contrat ; utilisez le chat ou le script fourni.
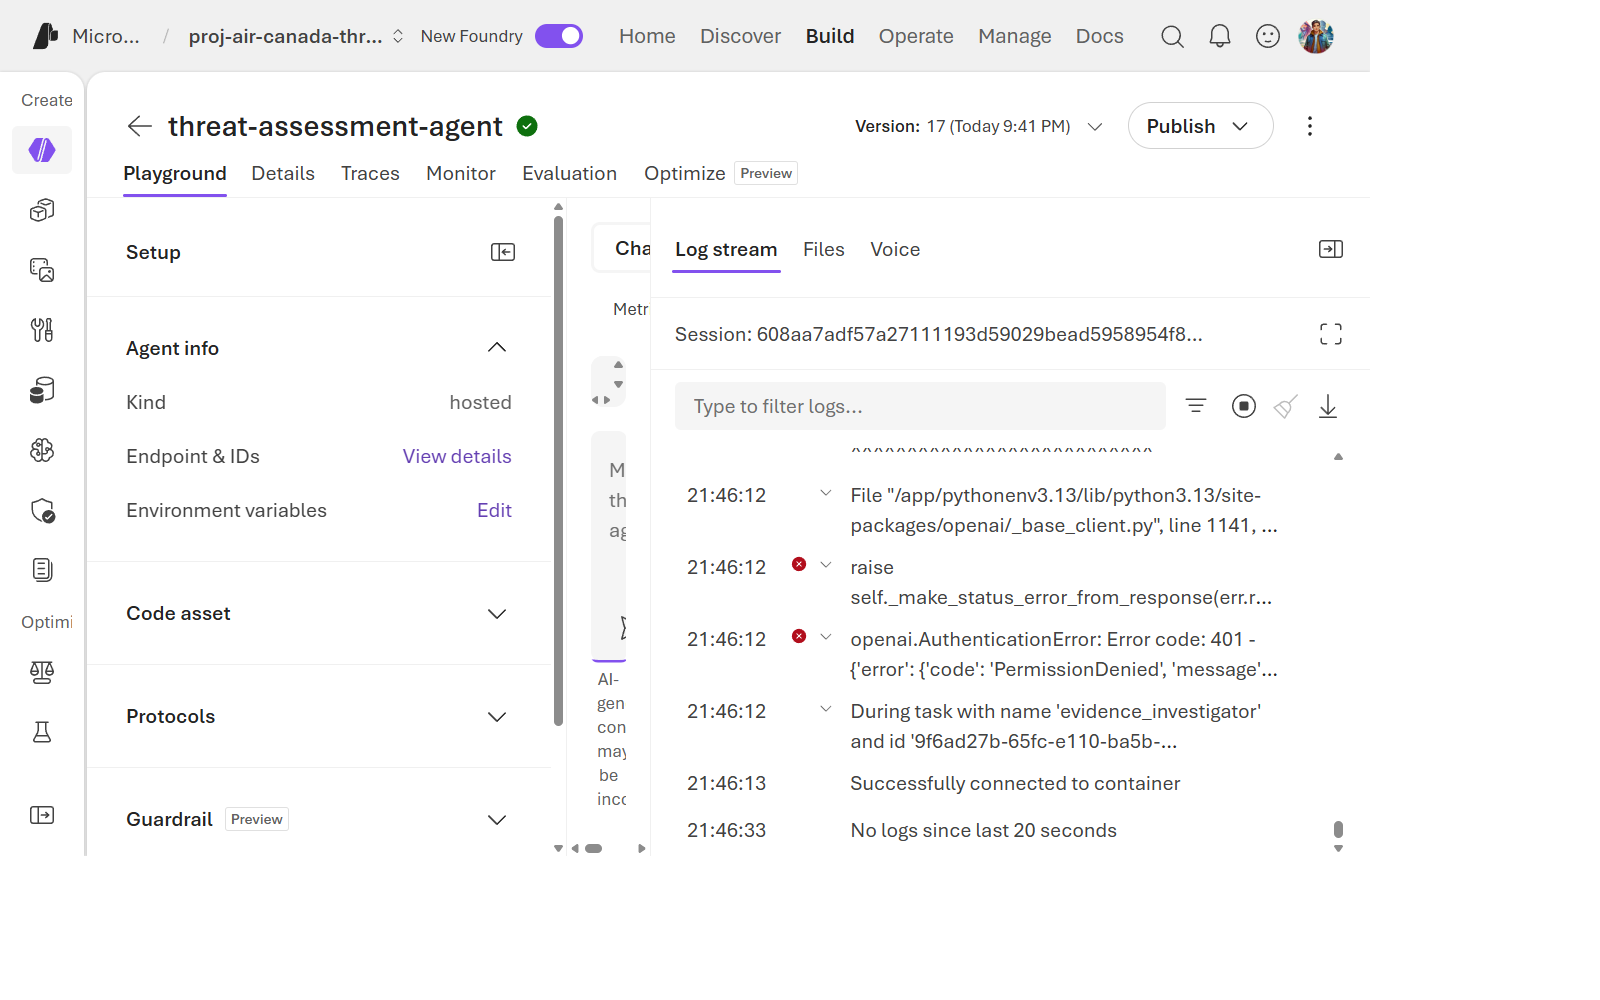
Capture historique du portail, pas le nouveau chat ni une preuve de la version actuelle.
Exercice 4.3 : Lire la trace
Ouvrez Application Insights → Application Map ou Transaction search pour le groupe de ressources de l’agent.
Trouvez la trace de votre invocation et identifiez :
- La décision de répartition du superviseur (quel spécialiste s’est exécuté en premier).
- L’appel d’outil de l’Enquêteur de preuves vers
defender-conn. - L’appel d’outil de l’Analyste de risque vers
anomaly-conn. - La portée de synthèse finale du Rédacteur de rapport — notez qu’elle n’a aucune portée d’appel d’outil sortant, cohérent avec la conception d’isolation des outils du Lab 01.
Pour Application Insights lié à un workspace, utilisez son espace Log Analytics.
Remplacez resp_REPLACE par l’identifiant brut (sans guillemets JSON) de
response.completed dans le SSE capturé :
AppTraces
| where TimeGenerated > ago(30m)
| where Message contains "resp_REPLACE"
| project TimeGenerated, OperationId, Message
Exigez une trace correspondante avant d’interpréter zéro AppExceptions comme
un signal de santé. Une requête vide, invalide ou échouée n’est pas un succès.
Corrélez dépendances et exceptions par OperationId, puis vérifiez séparément
les reçus bornés dans les artefacts d’évaluation. L’ingestion ne prouve ni la
couverture complète des spans ni l’endurance sous charge.
Exercice 4.4 : Reconnaître une réponse dégradée
Comparez l’exemple miss-001 du jeu de données de référence (dans
eval/golden-dataset.jsonl) — « la télémétrie Defender est indisponible »
— avec une réponse normale. Une réponse dégradée devrait :
- Ne jamais affirmer que l’hôte est propre lorsque des données manquent.
- Indiquer explicitement l’écart de données dans une section Limitations.
- Retourner un rapport complet si le graphe peut représenter la lacune ; ne jamais considérer HTTP 200 comme un succès si le flux SSE contient une erreur.
C’est l’indicateur evidence_tool_unavailable du
Lab 01 qui apparaît dans le texte réel du
rapport.
Exercice 4.5 : Rappel, isolation et limites des reprises
Les étapes interactives ci-dessous nécessitent le chat facultatif. Sans lui,
utilisez le vérificateur d’historique en direct et les tests backend de la section
suivante ; un appel isolé à invoke-agent.sh crée une nouvelle session et ne
peut pas démontrer le rappel.
- Dans l’évaluation crew-admin, envoyez
Keep investigation reference DEMO-73921 with this assessment. - Demandez
What investigation reference did I provide earlier?sans répéter la valeur. La référence exacte doit être identifiée comme fournie par l’utilisateur, pas comme preuve vérifiée par les outils. - Créez une nouvelle évaluation et posez la même question. Elle ne doit pas rappeler la référence de l’autre session. L’absence d’historique n’est pas une preuve de risque faible.
- Examinez
apps/web-chat/app.py: historique utilisateur/assistant complet géré par le backend,store:false. Les identifiants locaux du navigateur sont liés au propriétaire, pas aux conversations natives Foundry. - Vérifiez les tests de reprise : même clé et même message terminé, réponse rejouée ; texte modifié avec la même clé, HTTP 409 ; autre propriétaire, 404.
Sessions en mémoire : expiration après une heure, limite de 20 tours. Rechargement du navigateur : liste locale perdue ; redémarrage backend : état perdu. Ni historique durable, ni checkpoint Cosmos repris, ni garantie durable exactement-une-fois. Teams reste une étape future.
Exercice 4.6 : Tester l’historique sans déploiement web
Exécutez les trois assertions d’historique sur votre point de terminaison routé.
Le compte explicite n’accepte qu’un hôte aif-fha-learn-* correspondant.
$ProjectEndpoint = azd env get-value FOUNDRY_PROJECT_ENDPOINT
$WorkshopAccount = ([uri]$ProjectEndpoint).Host.Split('.')[0]
$ResponsesEndpoint = "$ProjectEndpoint/agents/$env:AGENT_NAME/endpoint/protocols/openai/responses?api-version=v1"
python eval/check_conversation.py --endpoint $ResponsesEndpoint --workshop-account $WorkshopAccount --output-dir .azure/workshop-conversation
Attendez 3/3 passed. Ce résultat démontre l’historique fourni par l’appelant sur
la route active, pas le stockage natif ni l’authentification du navigateur.
Examinez les flux enregistrés. L’application web facultative possède ses propres
tests d’isolation et de reprise ; le contrôle CLI ne prouve pas ces propriétés.
Vérification des connaissances
- Quel est le moyen le plus rapide de voir quel nœud spécialiste a traité une requête donnée — la réponse CLI, ou la trace ?
- Que devrait dire un rapport lorsque l’outil de l’Enquêteur de preuves est indisponible, et que ne devrait-il jamais dire ?
Prochaine étape
Passez au Lab 05 : Évaluations.